
Límites de caracteres por API: `.length` miente, y miente en las dos direcciones
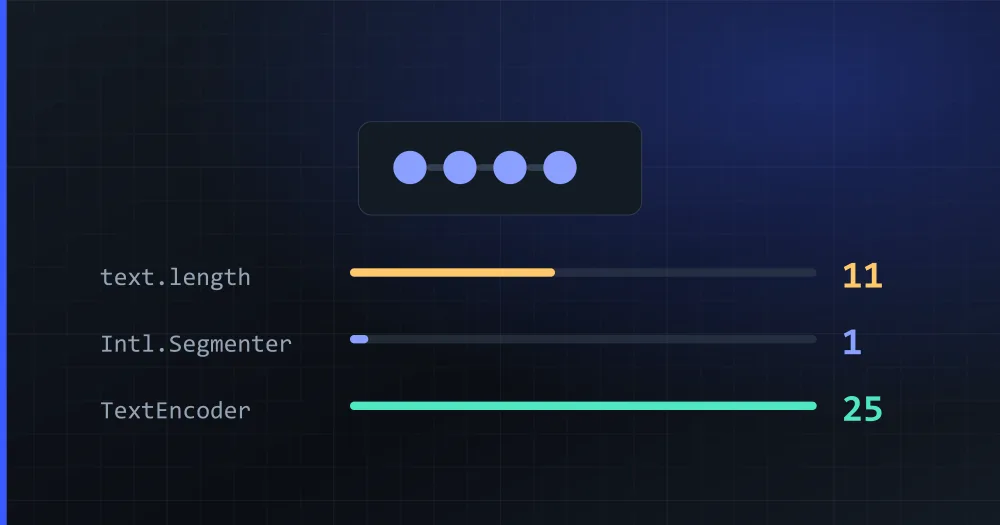
"👨👩👧👦".length es 11. Ese emoji es un carácter en pantalla, siete puntos de código Unicode y 25 bytes en el cable. Cuál de esos números usa una red social para medir tu publicación depende de la red. Si eliges el equivocado, o rechazas publicaciones que saldrían perfectas, o aceptas publicaciones que la API va a rechazar horas después, cuando ya están programadas.
Lo que sigue lo aprendimos construyendo una API de publicación red a red, y los números están comprobados contra las APIs reales, no copiados de su documentación.
¿De cuántas formas se mide un texto?
De cuatro: unidades UTF-16, puntos de código, grafemas y bytes. Para los límites de las redes importan tres; los puntos de código no sirven para ninguna.
const seg = new Intl.Segmenter(undefined, { granularity: "grapheme" });
const text = "👨👩👧👦";
text.length // 11 (unidades UTF-16)
[...text].length // 7 (puntos de código Unicode)
[...seg.segment(text)].length // 1 (grafemas)
new TextEncoder().encode(text).length // 25 (bytes UTF-8)
| Texto | .length |
puntos de código | grafemas | bytes |
|---|---|---|---|---|
👨👩👧👦 |
11 | 7 | 1 | 25 |
🙂 |
2 | 1 | 1 | 4 |
é |
1 | 1 | 1 | 2 |
漢 |
1 | 1 | 1 | 3 |
El emoji de familia son cuatro personas unidas por tres caracteres de ancho cero, y por eso desplegar la cadena (el primer truco que se suele probar) da 7 y no 1.
¿En qué unidad cuenta cada red?
| Red | Tope | Unidad |
|---|---|---|
| 63.206 | UTF-16 | |
| YouTube (descripción) | 5.000 | UTF-16 |
| 4.096 | UTF-16 | |
| Telegram | 4.096, o 1.024 con fichero | UTF-16 |
| Slack | 4.000 | UTF-16 |
| 3.000 | UTF-16 | |
| 2.200 | UTF-16 | |
| TikTok | 2.200 | UTF-16 |
| Discord | 2.000 | UTF-16 |
| Threads | 500 | grafemas |
| X | 280 | UTF-16 |
| Bluesky | 300 y 3.000 | grafemas y bytes |
Casi todas cuentan unidades UTF-16, que es exactamente lo que devuelve .length. Como acierta tantas veces, cuesta sospechar de él en las dos redes donde falla.
TikTok tiene otra trampa: su aplicación te deja escribir 4.000 caracteres y su Content Posting API rechaza a partir de 2.200. El número que vale es el del endpoint al que llamas, no el de la interfaz de la red.
¿Cómo mide Bluesky el texto?
Con dos topes a la vez, 300 grafemas y 3.000 bytes, y una publicación tiene que pasar los dos. Es la única red con dos límites de texto vivos al mismo tiempo.
.length falla con los dos, y en direcciones opuestas:
- Cuenta de más los emojis. 121 emojis de familia son 121 grafemas, cómodamente por debajo de 300, así que deberían publicarse.
.lengthdice 1.331 y los rechaza. - Cuenta de menos todo lo que no es latino. Esos mismos 121 emojis pesan 3.025 bytes y se pasan del tope en bytes: contando caracteres caben, y la red los rechaza. Un texto largo en japonés hace lo mismo, con tres bytes por carácter, y una publicación que parece corta revienta el techo de bytes.
Así que la comprobación tiene que ser doble:
const graphemes = countGraphemes(text);           // Intl.Segmenter
const bytes = countBytes(text);                   // Buffer.byteLength / TextEncoder

if (graphemes > 300 || bytes > 3000) {
    // rechazar, y decirle al usuario CUÁL de los dos ha sido
}
El mensaje tiene que decir cuál de los dos topes ha saltado: «Demasiado largo» delante de un contador que marca 180 caracteres es un error que el usuario no sabe cómo arreglar.
¿En qué unidad cuenta Threads?
En grafemas, y lo sabemos porque lo medimos. La documentación dice «500 caracteres» y añade que los emojis cuentan como bytes UTF-8: son dos lecturas plausibles que se contradicen. Así que mandamos dos sondas contra una cuenta real:
- 400 ×
🙂: 400 grafemas, 800 unidades UTF-16, 1.600 bytes → publica. - 400 ×
é: 400 grafemas, 400 unidades UTF-16, 800 bytes → publica.
Las dos se pasan de 500 en al menos una de las otras dos unidades, así que ni UTF-16 ni bytes pueden ser la regla.
Antes de esa medición validábamos con .length, y una publicación de 300 emojis se rechazaba por larga cuando la red la habría aceptado. De los dos errores posibles, ese es el caro. Una publicación que rechaza la API deja un error que se puede leer; una que rechaza tu propio producto deja al usuario mirando un contador que dice 300 de 500 y un mensaje que dice que se ha pasado.
¿Por qué Telegram cambia de tope al adjuntar una foto?
Porque el texto pasa a ir en otra llamada. El mismo campo del compositor tiene dos números:
- 4.096 sin adjunto, porque el texto sale como
sendMessage. - 1.024 en cuanto hay una foto o un vídeo, porque entonces el texto es el
captiondesendPhoto,sendVideoosendMediaGroup.
En una herramienta de publicación ese es el flujo normal: alguien escribe 2.000 caracteres, le gusta, arrastra una imagen, y la publicación que era válida hace un segundo falla con un 400 al publicar. El contador del compositor tiene que cambiar en el instante en que se adjunta el fichero, y el error, si aun así ocurre, tiene que decir que el tope bajó por el fichero.
¿Qué pasa si te pasas del tope de Slack?
Que no salta ningún error. El tope son 4.000 caracteres para chat.postMessage y, si te pasas, Slack trunca el mensaje o lo parte en varios. Tu panel enseña una publicación y el canal tiene dos.
Además, el texto de Slack hay que escaparlo (&, < y > son el principio de sus propias entidades, y un < suelto se come el resto de la frase), y escapar cambia la longitud: & se convierte en &, cinco caracteres donde había uno. Así que la comprobación de 4.000 cuenta el texto del usuario, que es lo que cuenta el compositor, mientras que el recorte de seguridad mide la cadena escapada y tiene que cortar sin dejar media entidad colgando. Cortar en el carácter 4.000 a secas publicó una vez un &am visible.
¿Cómo se cuenta cada unidad?
Los grafemas, con Intl.Segmenter; los bytes, con Buffer.byteLength:
/** Grafemas: lo que una persona llama «un carácter». */
export const countGraphemes = (text: string): number =>
    [...new Intl.Segmenter(undefined, { granularity: "grapheme" }).segment(text)].length;

/** Bytes UTF-8: lo que viaja por el cable. */
export const countBytes = (text: string): number => Buffer.byteLength(text, "utf8");
Intl.Segmenter necesita el lib de TypeScript en ES2022 o superior (el nuestro está fijado ahí mientras target se queda más abajo, solo por esto). Y segmentar tiene coste: reserva un segmento por grafema, así que cuenta una vez y pasa el número, en vez de llamarlo dentro de un bucle sobre mil publicaciones.
¿Dónde deben vivir los límites de cada red?
En un solo sitio, en manos de quien los valida, y publicados por la API. Cada fallo de los de arriba se arregla una vez y sale barato. El caro es que la pantalla que cuenta y el servidor que valida guarden copias separadas de los números.
Así derivó el nuestro: el compositor contaba LinkedIn hasta 3.000 mientras el servidor rechazaba en 1.300 (un número que quedaba de un endpoint que ya no llamábamos), y el usuario se enteraba al publicar. Lo arreglamos dejando los números en un solo sitio, el servidor, que los publica:
curl https://api.planvortex.com/v1.0.0/social_limits \
  -H "Authorization: Bearer $TOKEN"
Ese endpoint devuelve el tope de caracteres, el de bytes, el del título, el número de imágenes, la duración de vídeo y el tamaño de fichero de cada red, así que un compositor no tiene que escribir ninguno a mano.
Si estás construyendo lo mismo, es la pieza que más vale copiar. Si prefieres no construirla, la API de PlanVortex cuenta por ti, en la unidad de cada red, antes de que nada llegue a la red social.
Y si publicas desde el panel, el compositor cuenta en esas mismas unidades, red por red, mientras escribes.
¿Por qué `.length` de JavaScript no sirve para los límites de caracteres de las redes?
Porque `.length` cuenta unidades UTF-16, y no todas las redes miden así. Un emoji de familia son 11 unidades UTF-16, 7 puntos de código, un grafema y 25 bytes UTF-8. En Bluesky, que cuenta grafemas, `.length` rechaza publicaciones que la red aceptaría; contra el segundo tope de esa misma red, que va en bytes, deja pasar publicaciones que la red rechaza. De los dos errores, el caro es el primero: al usuario se le prohíbe algo publicable sin que pueda entender por qué.
¿Qué redes cuentan grafemas en vez de caracteres?
Bluesky y Threads. Los 300 de Bluesky son 300 grafemas, y los 500 de Threads son 500 grafemas, medidos contra la API real y no leídos en la documentación. Las demás redes en las que publicamos miden en unidades UTF-16, que es justo lo que devuelve `.length`, así que usar `Intl.Segmenter` allí las rompería en la dirección contraria.
¿Telegram tiene un límite de caracteres o dos?
Dos, para el mismo campo, y cuál manda depende de si la publicación lleva fichero. El texto solo sale como `sendMessage` y tiene 4.096 caracteres; en cuanto hay una foto o un vídeo, ese texto pasa a ser el `caption` de `sendPhoto`, `sendVideo` o `sendMediaGroup` y el tope baja a 1.024. El compositor tiene que cambiar el contador al adjuntar el fichero, no al pulsar publicar.
¿Qué pasa si te pasas de los 4.000 caracteres de Slack?
No salta ningún error. Slack no rechaza un texto más largo: lo trunca o lo parte en varios mensajes. Tu panel enseñaría una publicación y el canal tendría dos, sin un error en ningún sitio que lo explique.
¿Dónde deben vivir los límites de cada red en una integración?
En un solo sitio, en manos de quien los valida, y publicados por la API. Si el compositor guarda su propia copia de los números, derivan: el nuestro contaba LinkedIn hasta 3.000 mientras el servidor rechazaba en 1.300, y el usuario se enteraba al publicar. PlanVortex los expone en `GET /social_limits`, así que la pantalla que cuenta y el servidor que valida no pueden decir cosas distintas.